conv.

← The whole story
AI
GoBench benchmark measures LLM reasoning on 9x9 Go against KataGo

Roland31415 introduces GoBench LLM evaluation framework

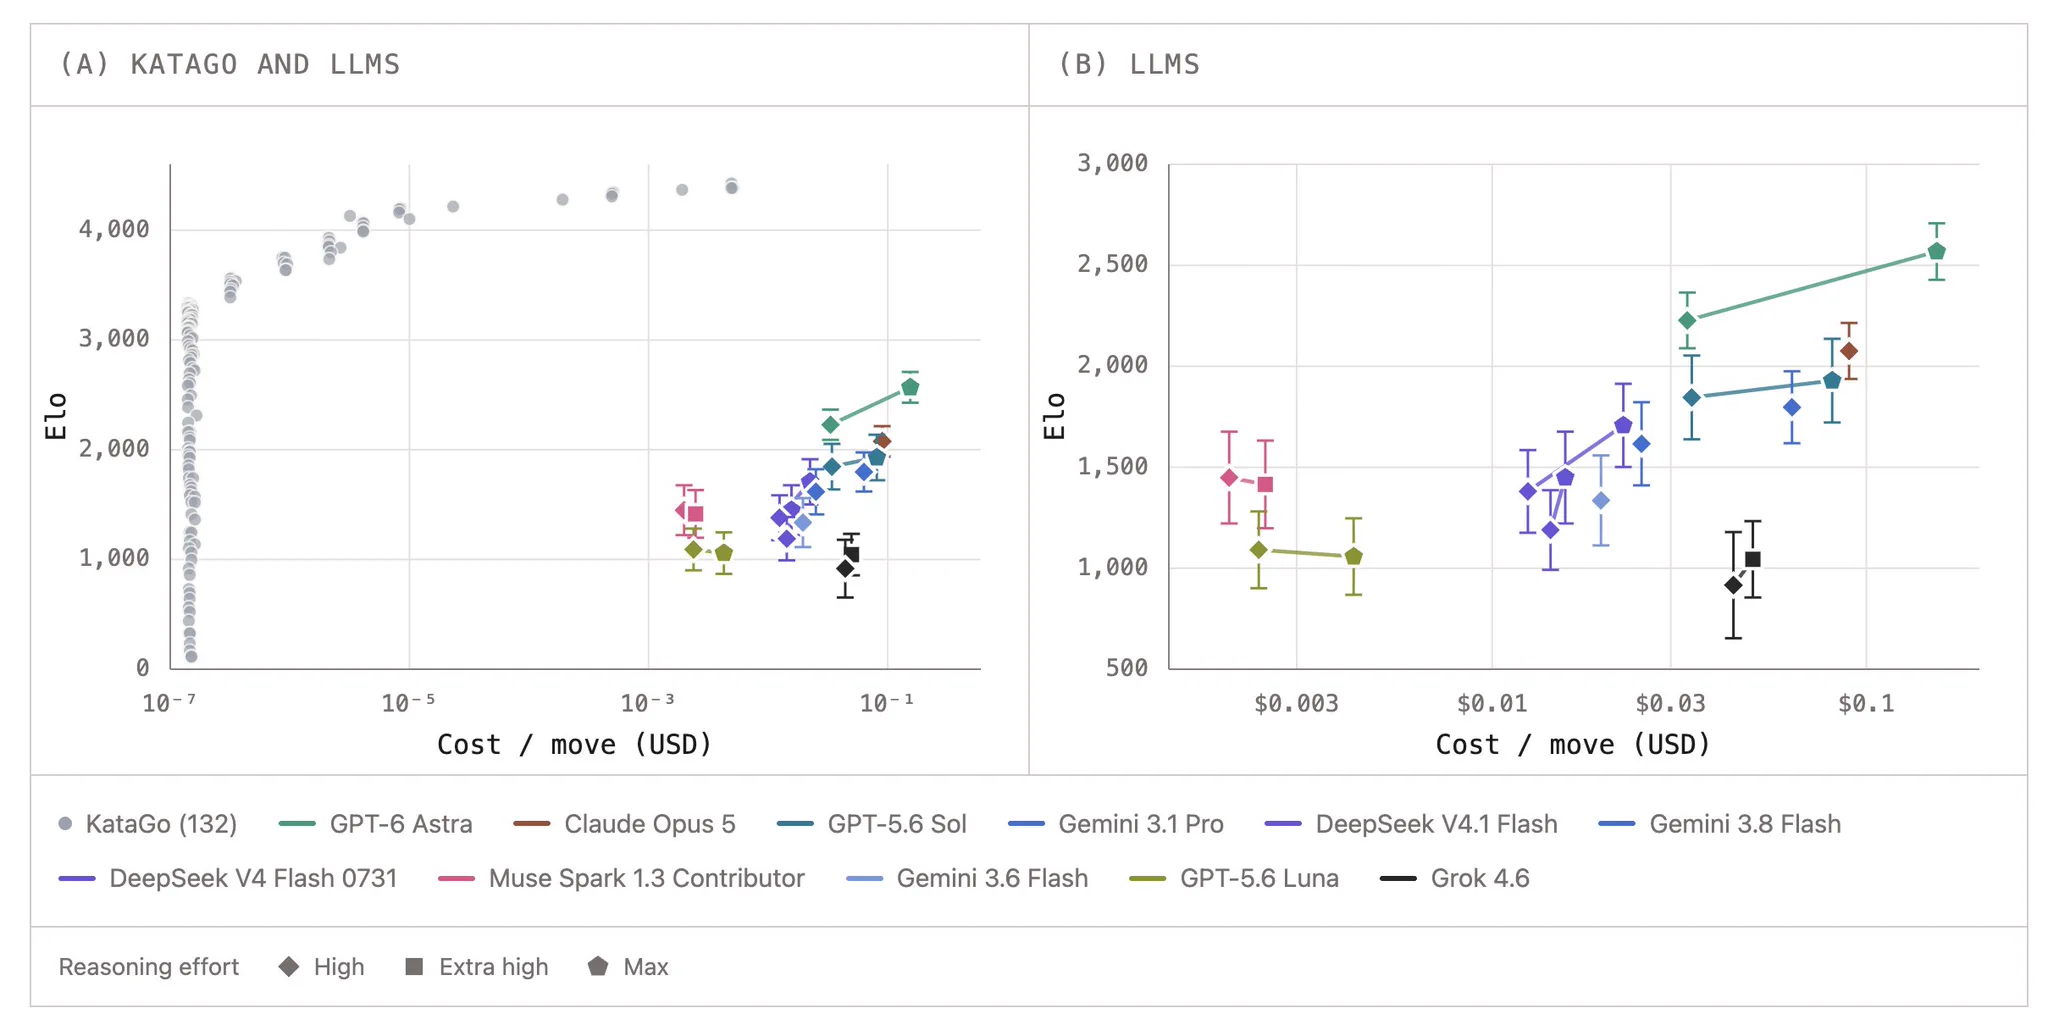
GoBench evaluates large language models by having them play 9x9 Go against a ladder of KataGo opponents from random to superhuman skill. GPT-6 Astra max, the strongest LLM tested, achieves 2500 Elo compared to KataGo's 4400 Elo peak.

Roland31415 introduces GoBench LLM evaluation framework
x.com

“Introducing GoBench, where LLMs play 9x9 Go against KataGo players, from random to superhuman.”

@Roland65821498

Roland31415 GoBench creator

The whole story postscomments the bright band is this development · numbered dots are the others · click one to jump

Peak 3 pieces in 3h at Sep 16, 2 PM; 4 pieces over 12 days (2 posts · 2 comments) Sep 16, 11 AM — 1 piece · 1 post — X 1Sep 16, 2 PM — 3 pieces · 1 post · 2 comments — Reddit 3Sep 16, 5 PM — quietSep 16, 8 PM — quietSep 16, 11 PM — quietSep 17, 2 AM — quietSep 17, 5 AM — quietSep 17, 8 AM — quietSep 17, 11 AM — quietSep 17, 2 PM — quietSep 17, 5 PM — quietSep 17, 8 PM — quietSep 17, 11 PM — quietSep 18, 2 AM — quietSep 18, 5 AM — quietSep 18, 8 AM — quietSep 18, 11 AM — quietSep 18, 2 PM — quietSep 18, 5 PM — quietSep 18, 8 PM — quietSep 18, 11 PM — quietSep 19, 2 AM — quietSep 19, 5 AM — quietSep 19, 8 AM — quietSep 19, 11 AM — quietSep 19, 2 PM — quietSep 19, 5 PM — quietSep 19, 8 PM — quietSep 19, 11 PM — quietSep 20, 2 AM — quietSep 20, 5 AM — quietSep 20, 8 AM — quietSep 20, 11 AM — quietSep 20, 2 PM — quietSep 20, 5 PM — quietSep 20, 8 PM — quietSep 20, 11 PM — quietSep 21, 2 AM — quietSep 21, 5 AM — quietSep 21, 8 AM — quietSep 21, 11 AM — quietSep 21, 2 PM — quietSep 21, 5 PM — quietSep 21, 8 PM — quietSep 21, 11 PM — quietSep 22, 2 AM — quietSep 22, 5 AM — quietSep 22, 8 AM — quietSep 22, 11 AM — quietSep 22, 2 PM — quietSep 22, 5 PM — quietSep 22, 8 PM — quietSep 22, 11 PM — quietSep 23, 2 AM — quietSep 23, 5 AM — quietSep 23, 8 AM — quietSep 23, 11 AM — quietSep 23, 2 PM — quietSep 23, 5 PM — quietSep 23, 8 PM — quietSep 23, 11 PM — quietSep 24, 2 AM — quietSep 24, 5 AM — quietSep 24, 8 AM — quietSep 24, 11 AM — quietSep 24, 2 PM — quietSep 24, 5 PM — quietSep 24, 8 PM — quietSep 24, 11 PM — quietSep 25, 2 AM — quietSep 25, 5 AM — quietSep 25, 8 AM — quietSep 25, 11 AM — quietSep 25, 2 PM — quietSep 25, 5 PM — quietSep 25, 8 PM — quietSep 25, 11 PM — quietYesterday, 2 AM — quietYesterday, 5 AM — quietYesterday, 8 AM — quietYesterday, 11 AM — quietYesterday, 2 PM — quietYesterday, 5 PM — quietYesterday, 8 PM — quietYesterday, 11 PM — quietToday, 2 AM — quietToday, 5 AM — quietToday, 8 AM — quietToday, 11 AM — quietToday, 2 PM — quietToday, 5 PM — quietToday, 8 PM — quiet 1–4
Sep 17Sep 18Sep 19Sep 20Sep 21Sep 22Sep 23Sep 24Sep 25yesterdaynow · 11:48 PM ET

What people said 1 voice · verbatim

All 4 developments of GoBench benchmark measures LLM reasoning on 9x9 Go against… →

RedditX